

Conceptos para esta lectura (4)
Puedes consultar las definiciones aquí o seguir los términos subrayados en el texto.
- Computación en la nube
- Uso de recursos informáticos y servicios gestionados a través de una red. Sus capacidades y responsabilidades dependen del servicio contratado.
- Redundancia
- Disponibilidad de recursos alternativos para mantener o recuperar una función si falla uno de sus componentes. Debe comprobarse cómo se activan y qué dependencias comparten.
- Punto único de fallo
- Componente del que depende una función y cuyo fallo puede interrumpirla al no existir una alternativa operativa para esa dependencia.
- Resiliencia operativa
- Capacidad de mantener o recuperar funciones esenciales ante una interrupción. En esta explicación se examina mediante dependencias, alternativas y pruebas de recuperación.
La infraestructura que solo vemos cuando falla
Una aplicación puede estar en tu teléfono y depender de una instalación que nunca has visto.
La computación en la nube permite contratar capacidad informática, almacenamiento y servicios gestionados. Esa comodidad deja en segundo plano una pregunta importante: qué sigue funcionando cuando falla una de sus dependencias.
El incidente de Londres ofrece un caso para examinarla. Conviene empezar por separar lo documentado de las consecuencias que todavía no podemos atribuir con suficiente respaldo.
Qué confirma el registro de Google
Google registró el incidente entre las 06:08 y las 14:00 UTC del 20 de octubre de 2026, una duración de 7 horas y 52 minutos. Son las 08:08 y las 16:00 en Madrid. El proveedor describió una incidencia eléctrica, indisponibilidad en la zona europe-west2-b y errores en algunos servicios de la región londinense europe-west2 [1].
La última actualización visible, a las 14:03 UTC, hablaba de mitigación para la mayoría y de un número muy reducido de clientes todavía afectados. El cierre del registro no acredita que todos los clientes hubieran recuperado cada operación. Google anunció un análisis posterior a su investigación interna, que no aparece en la página consultada [1].
No describimos una caída total de toda la región. Tampoco enumeramos bancos o servicios públicos afectados, porque sus consecuencias concretas no han quedado corroboradas en las fuentes recuperables de este cierre.
Servicios distintos pueden compartir una misma dependencia
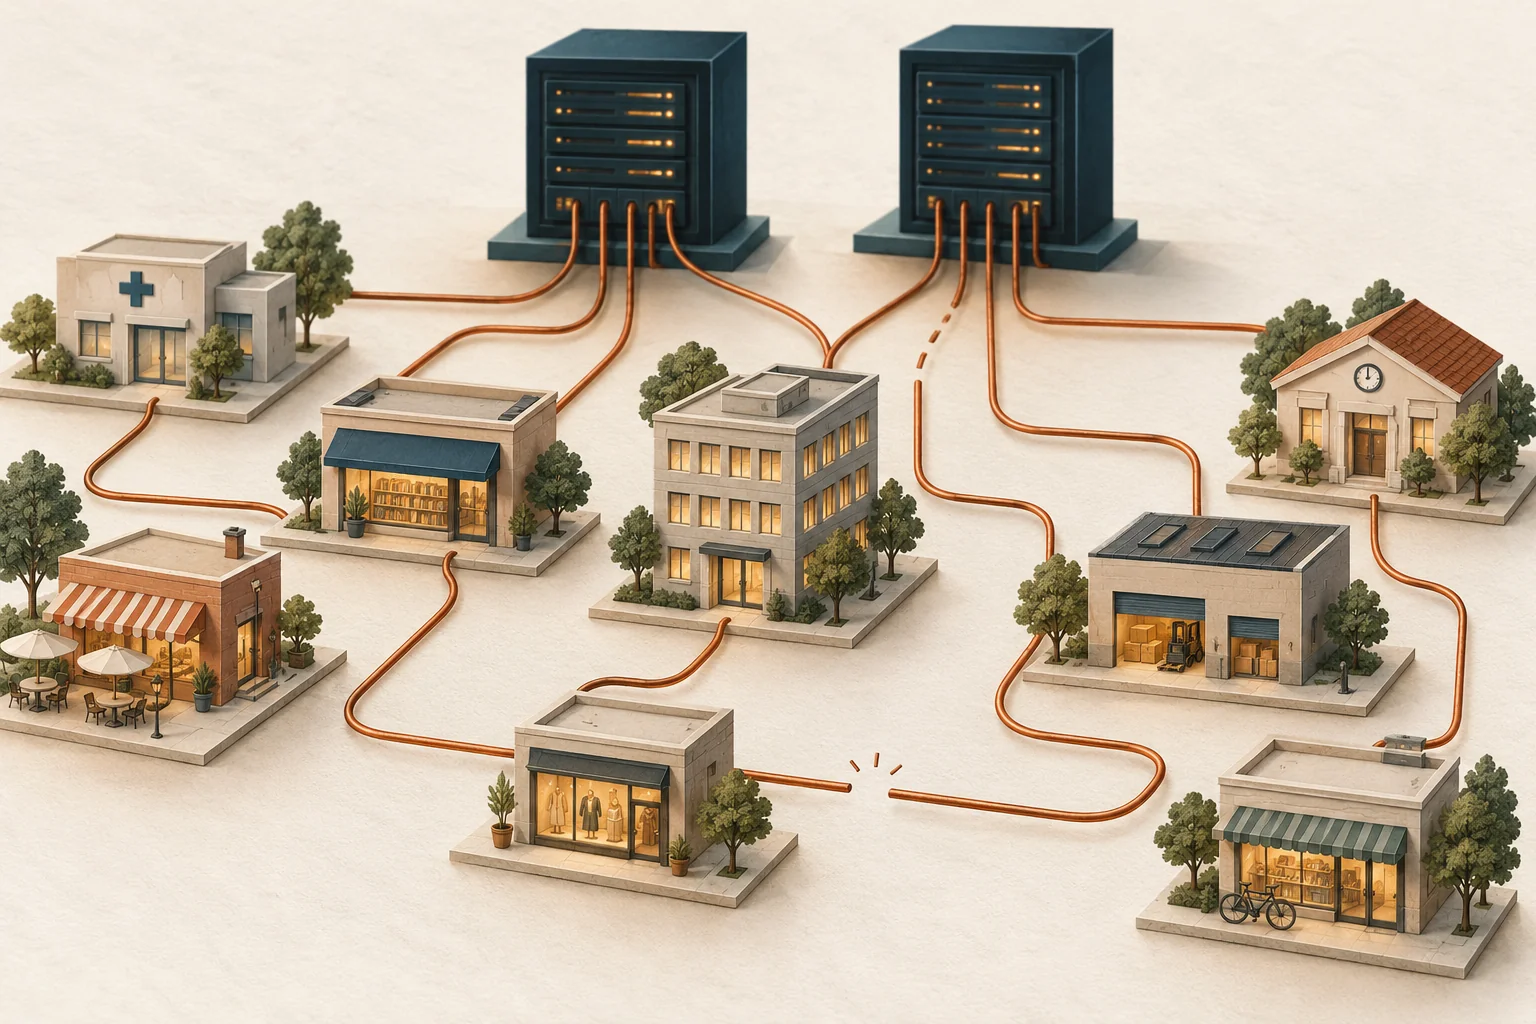
Imaginemos una tienda, una empresa de transporte y una aplicación de pagos. Son ejemplos hipotéticos. Sus clientes podrían considerarlas alternativas independientes y, sin embargo, las tres podrían depender de un mismo componente informático.
Ahí aparece el riesgo de concentración. Diversificar actividades comerciales no asegura diversificar la infraestructura que las sostiene. La pregunta es dónde coinciden las dependencias y qué ocurre si una deja de responder.
Esto no permite concluir que toda concentración sea perjudicial. Compartir una plataforma también puede reducir costes y facilitar capacidades que una organización pequeña no podría mantener por sí sola. El análisis exige comparar esas ventajas con las consecuencias de una interrupción.
Tener varias máquinas no resuelve por sí solo la continuidad
La guía de Google distingue fallos de recursos, zonas y regiones. Recomienda evitar dependencias sin alternativa y distribuir componentes según el nivel de protección buscado. Un punto único de fallo puede interrumpir una función esencial. Una aplicación puede seguir siendo vulnerable si conserva una dependencia esencial en un único lugar [2].
La resiliencia operativa es la capacidad de mantener o recuperar funciones esenciales ante una interrupción. La redundancia consiste en disponer de recursos alternativos. Para valorar su utilidad hay que preguntar cómo se activan, qué datos necesitan y cuánto tarda la recuperación. La guía explica opciones de diseño, no demuestra qué arquitectura tenía cada cliente del incidente.
Como criterio de análisis, proponemos medir la continuidad desde la operación que necesita completar una persona. En un ejemplo hipotético, poder abrir una aplicación pero no terminar un pago dejaría sin resolver su función esencial. Contar servidores encendidos no respondería por completo a esa pregunta.
Por qué también interesa a los reguladores
La FCA anunció el 10 de julio que, desde el día 13, supervisaría junto al Banco de Inglaterra y la PRA a los primeros cuatro proveedores críticos designados por el Tesoro: AWS, Google Cloud, Microsoft y Oracle. El comunicado explica el riesgo de que una interrupción compartida alcance a varias entidades o mercados. El régimen complementa las responsabilidades de las entidades financieras sobre sus propios proveedores [3].
Esa supervisión aporta contexto. No demuestra que este incidente constituya un incumplimiento ni permite repartir responsabilidades sin conocer la investigación y las configuraciones implicadas.
Cuatro preguntas antes de dar por resuelto el riesgo
¿Qué operación debe mantenerse? Una empresa necesita definir qué resulta esencial para sus usuarios y qué interrupción puede soportar. La respuesta no tiene por qué ser igual para todos sus servicios.
¿Se ha probado la alternativa? Tener un plan escrito y conseguir que funcione durante un fallo son resultados distintos. Nuestra propuesta es pedir evidencias de recuperación y conocer sus límites.
¿Qué dependencia sigue siendo común? Dos entornos pueden compartir componentes. Conviene examinar cuáles son, en lugar de deducir independencia únicamente del número de servidores o contratos.
¿Es proporcionado el coste? La continuidad exige recursos y trabajo. La decisión económica consiste en compararlos con el daño que provocaría una interrupción, sin suponer que toda redundancia adicional aporta el mismo valor.
Una necesidad tecnológica no garantiza una inversión rentable
Una línea de análisis posible son las soluciones de recuperación, seguimiento del funcionamiento y gestión de incidentes. Su interés requiere investigación, sin suponer que este episodio haya generado contratos o beneficios nuevos.
Una necesidad puede ser real y resultar difícil de monetizar. Para valorar a una empresa harían falta datos sobre demanda, costes, competencia y caja. La existencia de un problema importante no garantiza que cualquier proveedor que prometa resolverlo vaya a crear valor.
Qué podría cambiar nuestra lectura
El informe técnico podría modificar la interpretación del desencadenante y de la recuperación. Las arquitecturas de los clientes permitirían distinguir mejor las dependencias compartidas de las decisiones individuales de diseño.
Si aparecieran evidencias de que las alternativas funcionaron y limitaron el daño, también habría que incorporarlas. Un incidente aislado no demuestra que los fallos de la nube sean cada vez más frecuentes. Esa afirmación necesitaría una comparación histórica homogénea.
Hechos
Hecho con fuente
- El registro sitúa el incidente del 20/10 entre las 06:08 y las 14:00 UTC y distingue una zona indisponible de errores en algunos servicios regionales. [1]
- El último aviso mantiene una salvedad para un número reducido de clientes y anuncia un análisis posterior. [1]
- La guía de diseño distingue protección frente a fallos de recursos, zonas y regiones. [2]
- La FCA anunció supervisión conjunta de los primeros cuatro proveedores críticos desde el 13/07/2026, complementaria a las responsabilidades de las entidades. [3]
Inferencias
Inferencia
- Actividades comerciales distintas pueden conservar dependencias tecnológicas comunes. El alcance real exige conocer su arquitectura.
- La demanda de continuidad es una línea de investigación, sin evidencia aquí de nuevos ingresos para proveedores concretos.
Opinión editorial
Opinión
Hemos aprendido a dar por normales servicios que dependen de una infraestructura poco visible. Esa comodidad tiene valor, pero también puede alejarnos de las preguntas sobre su continuidad.
La revista propone tratar la capacidad de recuperación como una parte de la calidad del servicio. Para un usuario, importa poder terminar la operación que necesita. Una explicación técnica debe ayudarle a entender qué ocurrió y qué alternativas existen.
Defendemos un criterio proporcionado. No todos los servicios requieren el mismo gasto ni la misma velocidad de recuperación. Lo exigible es que las decisiones sobre esos límites sean explícitas y se comprueben, especialmente cuando afectan a funciones esenciales.
El tamaño de una plataforma aporta capacidades, pero no sustituye el examen de cada dependencia. Del mismo modo, añadir proveedores no demuestra por sí solo que una alternativa vaya a funcionar. La pregunta útil es qué evidencia tenemos de que el servicio puede recuperarse.
La madurez digital también se mide por esa respuesta: comprender qué puede fallar, reconocer los límites y comprobar cómo se mantiene lo esencial cuando ocurre.
Riesgos
- El panel del proveedor es una fuente propia del incidente, no una auditoría independiente.
- No conocemos la arquitectura de los clientes ni un informe técnico definitivo en el corte consultado.
Contraargumentos
- Los recursos de una gran plataforma pueden ofrecer capacidades de continuidad superiores a las de una instalación propia. Este episodio no permite resolver esa comparación.
- Multiplicar entornos puede introducir costes y complejidad. Su conveniencia depende de los requisitos y de las pruebas de recuperación.
Catalizadores
- Publicación del análisis técnico y de información verificable sobre recuperación y efectos concretos.
Cuándo se invalida la tesis
- Se revisará la interpretación si el informe técnico o evidencias contrastadas cambian el alcance del incidente o muestran que las dependencias señaladas no explican sus consecuencias.
Metodología
Elaborado con asistencia de IA a partir del borrador editorial y tres fuentes originales enlazadas. Se distingue el incidente documentado, los ejemplos hipotéticos y la interpretación. Se han retirado atribuciones a entidades concretas que no se pudieron corroborar. No se ha realizado una auditoría técnica independiente.
Potenciales conflictos de interés
Sin publicidad, afiliación ni recomendación de activos en esta pieza. No se ha realizado una verificación independiente de posibles conflictos de interés.
Fuentes
- [1] Registro del incidente de Londres, 20/10/2026 — Google Cloud Service Health · fuente primaria · consultada el 21 de octubre de 2026
- [2] Design reliable infrastructure for your workloads, revisión 23/09/2026 — Google Cloud Architecture Center · fuente primaria · consultada el 21 de octubre de 2026
- [3] UK financial regulators to begin overseeing Critical Third Parties, 10/07/2026 — Financial Conduct Authority · fuente primaria · consultada el 21 de octubre de 2026